课堂笔记与读书摘抄
手写笔记可转成能检索的 Markdown;标题与列表只有识别出来时才保留,核对后再放进语雀、Obsidian 或飞书继续整理。
拍完不是照片,而是一篇可以继续编辑的笔记。普通照片与手写走 Moondream;只有服务端确认的密集截图才切成 2–3 片交给 Llama 4 Scout。
确认后才上传所选照片 · 需要付费账户 · 原图与结果都不会自动保存
手机上点「拍一页试试」直接调起后置相机;电脑上选择或拖入最多 3 张 JPEG、PNG、WebP 图片。
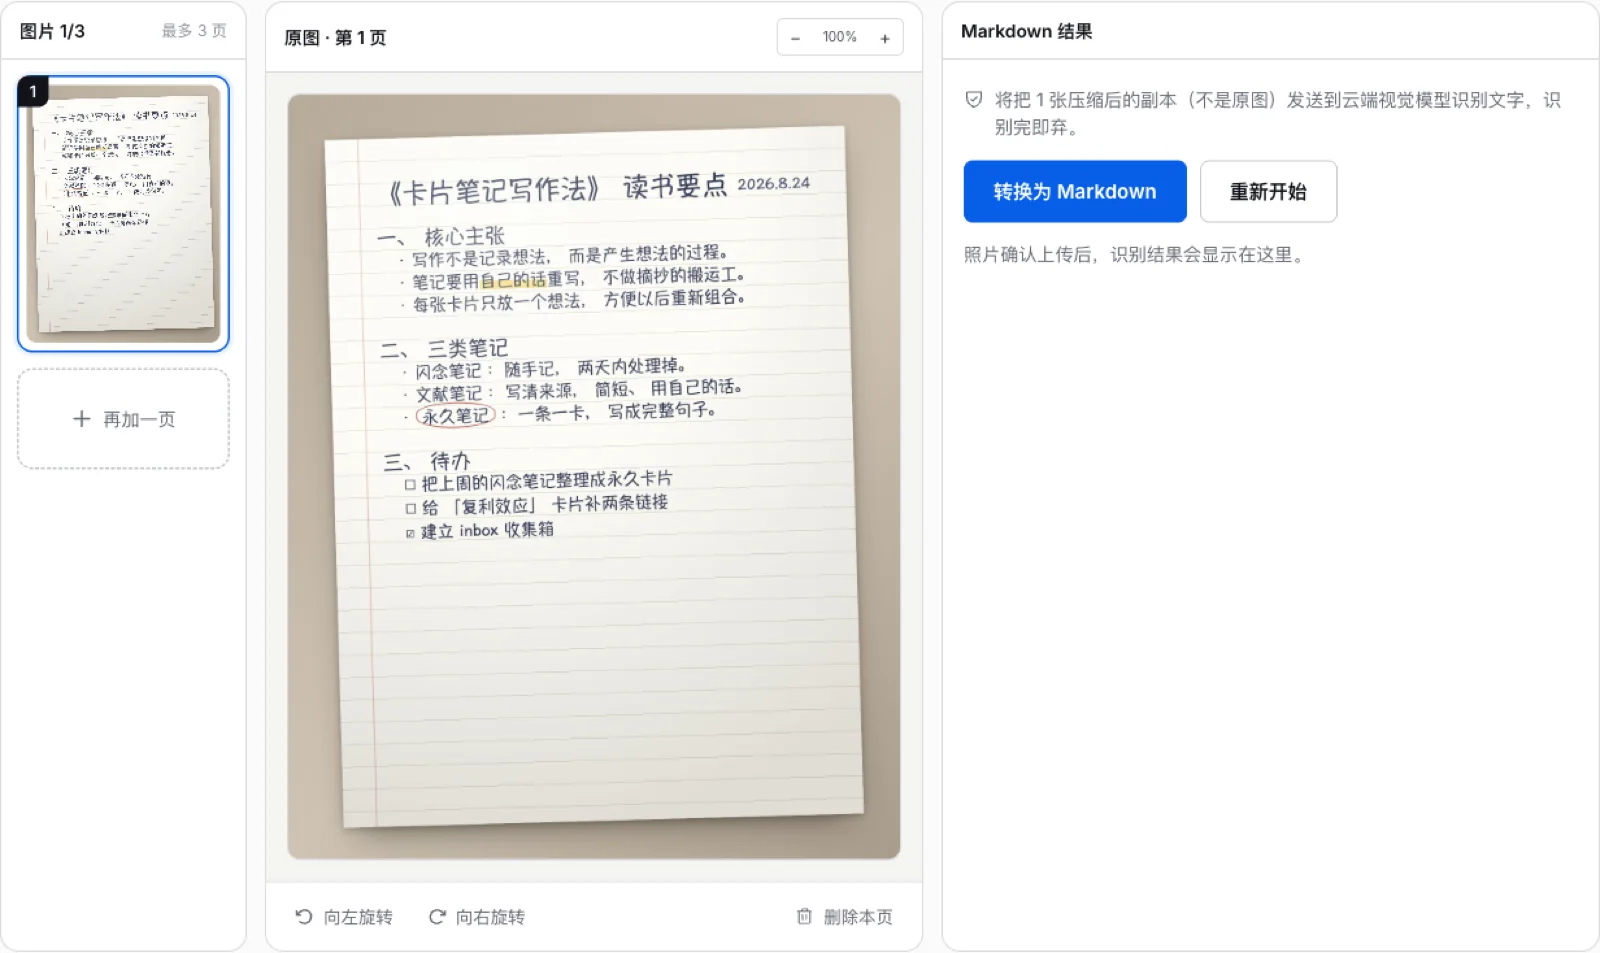
照片先在本地压缩,进入下图的工作台:左侧排页序、可旋转删除,中间对照原图。在你点「转换为 Markdown」之前,什么都不会上传。
识别结果按区块返回;模型给出的置信度会被保留,低值高亮,没返回则明确显示不可用。改完即可复制,或导出 Obsidian / 纯净 .md。
请复制或导出以保留结果
手机直接调起后置相机,桌面端选择或拖入文件。上传前可以在页堆里排序、旋转、删除。
照片先在浏览器里校正方向、缩放并压缩。页面会先告诉你将发送几张压缩副本,你点了「转换」才会上传。
普通照片与手写继续使用 Moondream。只有服务端像素分析确认是密集截图,才切成 2–3 个带重叠的片段交给 Llama 4 Scout;边界只删除精确重叠,拿不准的正文会保留给你核对。
所选模型返回数值置信度时,低于阈值的块会在原图旁边高亮;若没有返回,界面会明确说明,不会补一个看似中立的分数。
从 Word 导出的 PDF 自带文字层,而你亲手写下的那页纸只有像素。图片转 Markdown 和 PDF 转换是两件事,Markdown 相机专门解决前者——把手写笔记转 Markdown、把白板和讲义拍成可编辑的分块文本:
手写笔记可转成能检索的 Markdown;标题与列表只有识别出来时才保留,核对后再放进语雀、Obsidian 或飞书继续整理。
散会擦板之前拍一张。识别出的方框行动项可转成 Markdown 待办,核对后再贴进任务系统或会议纪要。
只存在于纸面上的练习卷、单页材料、批注过的打印稿走同一条路——印刷体的识别比手写更稳。
很多同类工具围绕英文打造,中文只是顺带支持。markdown相机把中文笔记当作默认场景:转写保持原文语言,不会把中文页「翻译」成英文结构。下面是拍照转markdown 在中文笔记里的行为约定——能稳的直说,不稳的也直说:
拿不准的判断交还给你:有数值置信度就保留并高亮低值,没有就明确显示不可用。
每个工具的边界不同:Word .docx 在浏览器本地转换;PDF 先本地分析,再走 Cloudflare 文档转换或 Moondream OCR。Markdown 相机里的普通照片与手写使用 Moondream;只有服务端确认的密集截图才临时切成 2–3 片并交给 Llama 4 Scout。
真正发送的是你确认过的那几张照片的压缩副本——不会扫描相册,原图不出设备。副本只用于识别、不作为你的文件保存;结果只留在当前会话,直到你复制或导出,不会自动保存到账户。
一个诚实的 markdown相机应该说清边界。工整手写和印刷体更容易识别,模型也能返回标题、列表、方框待办和简单表格;每份结果仍要你把关:
特别潦草或互相勾连的字——无论有没有置信度,都要逐字对照原图。
画线合并的复杂表格、化学式和矩阵这类密集记号。
密集截图可能跨过分片边界;合并时只删除精确重叠,因此保留下来的边界文字仍需核对。
靠箭头承载含义的思维导图式页面:输出里会描述这些标记,但不会替你重画。
暗光、阴影、大角度斜拍。重拍一张平整明亮的,比调任何参数都有用。
视觉模型仍可能生成看似合理的错误;低置信度或缺失置信度都是核对信号,重要内容必须对照照片。
输出就是普通 Markdown,Markdown 能去的地方它都能去。Obsidian 导出带 frontmatter 和标题大纲,拍下的一页可以直接归档进仓库;纯净导出贴进语雀、飞书文档或 GitHub 仓库都干净利落。
照片只是来源之一。文本 PDF 走本地分析加 Cloudflare 转换,.docx 留在本地并由word转markdown 工具附一份审计,质量指南讲如何核验任何转换。价格页说明文字 PDF 与 OCR 路径各自的页面点数成本。
实时图片识别需要付费账户,每张成功识别的原图扣 4 个页面点数。服务端确认的密集截图可能临时切成 2–3 片,但仍是一个逻辑页,只扣一次;转换失败扣 0 点。
只有登录并明确确认后才上传,发送的是压缩副本,仅用于识别。原图不出设备,服务端也不保存你的图片和结果。结果不会自动保存,请在离开前复制或导出。
工整的中英文手写由 Moondream 识别,印刷体通常更容易。转写保持原文语言;置信度只有所选模型返回时才显示,重要内容仍需对照照片。
一次最多 3 张原图。转换前在页堆里排好顺序,Markdown 会按这个顺序拼接;密集截图只有经服务端确认后才切成 2–3 个识别片段,这些片段仍算一个逻辑页。
当然也可以,但每次都要重写提示词,输出格式容易漂移。这里固定了经过校验的分块、确定性 Markdown 拼接、缺失证据提示和 Obsidian 导出。
系统提取文字通常只给一段纯文本。这里要求模型返回经过校验的区块,再由固定代码生成 Markdown;标题、待办、表格或公式只有识别出来时才保留,置信度没返回也会明确显示。
复制或导出「纯净 .md」后直接粘贴:语雀和 Notion 会把 Markdown 语法自动转成对应区块,飞书文档粘贴后也能识别常用语法。重度 Obsidian 用户直接用 Obsidian 导出,frontmatter 已经替你写好。
在页面里直接拍照得到的是 JPEG。如果从相册选了 HEIC 而浏览器解不开,页面会立刻提示——把照片另存为 JPEG(或者对着它截个图)就能解决。
使用付费账户进行实时识别,请对照原图核验,再在离开前复制或导出结果。